선박 유체성능 예측을 위한 선박 형상 표현 기법 기반 기계학습 모델 비교
This is an Open-Access article distributed under the terms of the Creative Commons Attribution Non-Commercial License(http://creativecommons.org/licenses/by-nc/3.0) which permits unrestricted non-commercial use, distribution, and reproduction in any medium, provided the original work is properly cited.
Abstract
Accurate prediction of ship hydrodynamic performance is essential for hull form optimization during the early design stage. This study investigates two approaches for incorporating ship hull geometry into machine learning-based surrogate models using offset data. The first approach represents hull geometry as an RGB image and applies a two-dimensional convolutional neural network (2D CNN), while the second directly utilizes offset curves with a one-dimensional CNN and a temporal convolutional network (1D CNN + TCN) to capture longitudinal hull form variations. Models for predicting the residual resistance coefficient, effective wake fraction, and thrust deduction factor were trained using approximately 440 model test dataset from the Korea Research Institute of Ships and Ocean Engineering (KRISO). Their performance was compared with a baseline multilayer perceptron (MLP) model using only principal ship dimensions. The results demonstrate that incorporating hull geometry significantly improves prediction accuracy over the MLP model. Although the average prediction performance of the 2D CNN and 1D CNN + TCN models was similar, the 1D CNN + TCN model achieved higher hull form sensitivity in propulsion performance prediction. These results indicate that offset-based hull representation provides an effective input for machine learning surrogate models and that TCN-based architectures are advantageous for capturing longitudinal hull form variations.
Keywords:
Hull form representation, Machine learning, Resistance performance, Propulsion performance, Convolutional neural network키워드:
선형 표현, 기계학습, 저항 성능, 추진 성능, 합성곱 신경망1. 서 론
선박의 설계는 크게 영업 설계, 기본 설계, 상세 설계 단계로 구분된다. 영업설계 단계에서는 주요제원을 결정하고 이를 기반으로 선박의 성능을 개략적으로 추정하는 단계로 선주의 계약 조건 충족 여부를 판단하고, 영업에 사용하기 위한 초기 선형을 설계한다. 이 단계에서는 주요 제원의 변화에 따른 성능 변화를 신속하게 예측할 수 있는 기법이 요구되며, 전통적으로 Holtrop (Holtrop, 1984, Holtrop and Mennen, 1978, 1982)의 회귀식을 사용하는 경우가 많다. Holtrop의 회귀식은 선박의 주요 제원을 입력으로 저항 및 추진 계수를 데이터베이스에 기초하여 예측하는 방법이다. 기본 설계 단계에서는 선주의 요구 조건을 만족하면서 유체역학적으로 성능이 우수한 선형을 설계하기 위해 반복적인 선형 수정과 CFD (Computational Fluid Dynamics) 해석을 통해서 최적 선형을 설계하고 모형시험을 통해서 검증하는 과정을 거친다. 이 단계에서 선박의 하부 형상(선도, lines)이 대부분 결정된다. 이후 상세 설계 단계에서는 화물창, 구조 설계 등 생산을 위한 설계를 진행한다. 영업 설계와 기본 설계 단계에서는 선박의 성능 예측이 매우 중요한 부분을 차지하고, 이를 위한 예측 기법의 정도와 예측 시간이 설계의 효율성을 높이는 핵심 역할을 하게 된다. Holtrop의 회귀식은 1980년대에 발표된 식으로, 별도의 계수 보정 없이 현시대의 선형에 직접 적용하기에는 한계가 있으며, 주요 제원 이외의 형상 특성이 성능에 미치는 영향을 반영하기 어렵다. CFD는 현재 모형시험을 제외하고 선박의 형상을 고려한 가장 신뢰성이 높은 유체성능 예측 도구로 현업에서 활발히 사용되는 방법이다. 그러나, 이를 위한 하드웨어 및 소프트웨어에 필요한 자원과 비용 문제로 여전히 대형 조선소를 제외하고는 접근이 쉽지 않은 실정이다. 모형시험은 가장 신뢰도가 높은 성능 검증 방법이나 시험준비와 수행에 많은 시간과 비용이 소요되므로 최종 설계 단계에서 성능을 검증하는 용도로 주로 활용되고 있다. 최근에는 Holtrop 회귀식 이후의 현대적인 선형들에 대한 모형시험 및 CFD 해석 결과 데이터의 전산화가 잘 이루어져 있고, 데이터 분석 기술의 발달로 인하여 주요 제원을 이용한 선형 성능 예측 정도 향상이 보고되고 있으며, 선형의 형상 특성을 반영한 복잡한 예측 모델의 개발도 활발히 이루어지고 있다. 이에 따라 회귀 기반 예측 모델의 활용 범위도 영업설계 단계의 초기 성능 추정을 넘어 CFD 수행 이전의 사전 필터링(pre-screening), 선형 최적화를 위한 대리자 모델(surrogate model), 그리고 설계 공간 탐색을 위한 예측 도구 등으로 확대되고 있다.
본 연구에서는 선박의 형상 정보를 기계학습 모델의 입력으로 활용하기 위한 형상 표현 방법을 제안하고, 대표적인 두 가지 형상 표현 방식에 기반한 기계학습 모델을 비교, 분석하였다. 학습 및 검증을 위한 선형과 데이터는 선박해양플랜트연구소(Korea Research Institute of Ships and Ocean engineering; KRISO)가 보유한 400여 척의 모형시험 결과를 사용하였다. 2장에서는 선박의 성능 예측을 위한 기존 회귀 연구에 대하여 소개하고, 3장에서는 본 연구에 사용된 기계학습 모델의 구성, 선형 정보 표현 방법에 대하여 설명한다. 4장과 5장에서는 저항 성능, 추진 성능 예측 결과를 비교, 분석하며, 마지막으로 결론과 향후 연구 방향을 제시한다.
2. 관련 연구
회귀를 이용한 선박의 성능 추정 연구로는 Holtrop의 방법이 가장 널리 알려져 있다. Holtrop의 방법은 선박의 주요 제원과 일부 형상 계수를 이용하여 선박의 저항, 반류계수, 추력감소계수를 추정하는 경험식을 제안하였으며, 현재까지도 회귀계수의 보정을 통해 실무에서 여전히 활용되고 있다. 그러나, 복잡한 형상으로 발달하는 유체의 흐름에 의해서 생기는 저항 성분, 추진 성분을 소수의 주요 제원으로 추정한다는 것은 근본적인 한계를 가지고 있으며 발표 이후 많은 설계 개념의 변화 및 다양성을 충분히 반영하기 어렵기 때문에 영업 설계 등의 제원 검토 수준에서 활용되고 있다. 주요 제원만을 이용한 회귀 모델의 정도를 높이는 방법으로 최근의 선형 성능 데이터를 이용한 신경망 모델을 생각할 수 있다. 최신 선형의 성능 정보를 학습할 수 있으며, 신경망 구조를 활용하여 복잡한 관계를 유추할 수 있다는 장점을 갖고 있어 Holtrop 회귀식의 대안으로 활용될 수 있다. 그러나 주요 제원만으로 표현할 수 없는 선형의 미세한 변화가 성능에 미치는 영향을 충분히 반영하기 어렵다는 한계가 존재한다. 이를 보완하기 위하여 선형의 형상 특성을 반영하는 다양한 추가 선형 변수를 이용하는 방법이 있지만, 이러한 방법은 별도의 형상 변수 계산 및 추출 과정이 필요하다는 단점을 갖는다(Kim et al., 2019).
보다 정밀한 선박의 성능 예측을 위해 최근에는 선박 형상 정보를 직접 활용하는 기계학습 기반 회귀 모델이 활발히 연구되고 있다. 이러한 연구들은 선박 형상을 다양한 형태로 표현(encoding)한 후 이를 기계학습 모델의 입력으로 사용하여 성능 지표를 예측하는 방식을 채택하고 있다. Cho et al. (2019)은 선박 단면의 오프셋(offset table) 좌표 정보를 입력으로 사용하여 Holtrop 회귀식으로 계산된 저항 계수를 추정하는 딥러닝 기반 대리자 모델을 제안하였다. Park et al. (2023)은 3차원 선박 표면을 복셀(voxel)로 표현하고, 합성곱 신경망(Convolutional Neural Network; CNN)을 적용하여 선박의 저항 성능을 예측하였다. Kim et al. (2022, 2023)은 선박의 오프셋 단면을 일정 크기의 픽셀 이미지로 변환하고, 각 셀에 SDF (Signed Distance Function)값을 저장하여 2차원 혹은 3차원 CNN 기반 저항 성능 예측 모델을 제안하고 그 성능을 비교하였다. Ichinose and Taniguchi (2021)은 CFD 계산용 메쉬로 표현된 선박의 표면 좌표(x, y, z)를 RGB 이미지로 변환하여 2차원 CNN을 이용한 선박 후류 유동장 예측 모델을 제안하였다. 또한 Kim et al. (2024)은 선박 오프셋 정보와 앞서 발표한 3차원 CNN을 이용하여 공칭 반류장을 예측하는 모델을 개발하여 학습 결과를 소개하고 그 활용성을 보인 바 있다. Seo et al. (2024)는 선박의 오프셋 단면의 표면 좌표에 오토인코더(autoencoder)를 적용하여 잠재벡터(latent vector)를 생성하고, 이를 이용하여 선박의 표면 압력장을 학습하여 예측하는 모델을 제안하였다.
3. 선형 표현 방법 및 예측 모델 구성
앞서 보인 관련 연구들에서는 선형의 형상 정보를 반영하여 성능 예측에 사용하기 위한 다양한 방법들을 도입하였다. 가장 단순한 방법인 대표 선형 변수를 이용한 방법은 선형간의 차이점을 구별하기 위한 지표의 수가 매우 제한적이기 때문에 정밀한 성능 예측에 사용할 수 없다. 선박의 오프셋 좌표를 단순히 다층퍼셉트론(Multi Layer Perceptron; MLP)에 입력하는 방식은 3차원 형상의 공간적 특성을 충분히 활용하기 어렵고, 형상의 계층적 특징을 효과적으로 학습하기 어렵다. 주변 영역의 특징을 학습하기 위하여 도입되는 것이 합성곱 신경망으로 CNN의 경우 국부적인 형상 특징을 효과적으로 학습할 수 있으나, 전체적인 형상 변화 등을 감지하는 것에는 단점을 갖고 있다. 3차원 복셀 데이터로 표현하는 방법은 표면을 N개의 복셀로 표현하기 때문에 형상 표현의 해상도에 제약을 받는다는 단점을 가지고 있다. CFD 계산용 메쉬를 이용하는 방법은 선체 표면을 표현하기 위한 정규격자 형태의 메쉬 생성 작업이 추가로 필요하며, 동일한 메쉬구조(mesh topology)을 다양한 선형에 적용해야 하는 어려움이 존재한다. 오토인코더의 잠재벡터를 이용한 회귀의 경우는 잠재벡터가 회귀에 유용하다는 보장이 없으며, 오토인코더의 학습을 추가로 수행해야 하는 비효율성이 존재하고, 잠재벡터 전부가 성능 예측에 유용하지 않을 수 있는 단점을 갖고 있다.
선박의 유체역학적 성능은 선체 표면을 따라 이동하는 유체의 흐름에 의해 결정된다. 이 과정에서 선수부부터 선미부까지 이어지는 형상 변화는 유동을 지속적으로 교란하며, 결과적으로 저항과 추진 성능에 영향을 미친다. 따라서 국부적인 형상 특징뿐만 아니라 길이방향의 형상 변화 패턴을 함께 고려하는 것이 성능 예측에 중요한 요소라고 할 수 있다.
본 연구에서는 별도의 형상 전처리 없이 일반적인 선형 설계 과정에서 생성되는 오프셋(offset) 정보를 입력으로 사용하였다. 국부적인 형상 패턴 학습을 위하여 CNN 방법을 이용하며, 길이방향 형상 변화를 고려할 수 있는 방법들을 제안하고, 학습 결과를 비교하였다.
3.1 오프셋 기반 선형 정보 벡터화
선박의 형상 정보를 회귀 모델의 입력으로 활용하기 위한 데이터는 일반적인 선형 설계 과정에서 쉽게 획득할 수 있어야 하며, 추가적인 형상 가공 없이 사용할 수 있는 정형화된 형태가 바람직하다. 또한 기계학습 모델의 학습 성능을 향상시키기 위해서는 선박 형상에 대한 도메인 지식을 내포하고 있어야 한다. 선박의 단면 오프셋(offset)은 이러한 조건을 만족하는 대표적인 형상 정보이며, 본 연구에서는 오프셋 데이터를 기계학습 모델의 입력으로 사용하기 위한 전처리 과정을 수행하였다. CNN 기반 모델에 적용하기 위해서는 각 단면의 형상을 일정한 크기의 텐서로 표현할 필요가 있다. 이를 위해 각 단면의 형상 곡선을 곡선 길이(arc length)를 기준으로 균일하게 분할하여 N개의 점으로 이산화하였다. 이 과정을 모든 축방향 단면(station)에 동일하게 적용함으로써 선박 형상을 N×M 크기의 점 집합(point set)으로 표현하였다. 여기서 N은 각 단면을 구성하는 점의 개수이며, M은 축방향 단면의 개수이다. 단면 형상을 구성하는 점은 모두 선저(bottom)에서 시작하여 최대 높이까지의 곡선을 따라 생성하였다(Fig. 1). 이때 단면 내부에 형상이 존재하지 않는 구간도 포함하여 하나의 연속된 곡선으로 취급하였으며, 선저부터 최대 높이까지 총 N개의 점으로 표현하였다. 점의 생성에는 형상 보존 특성이 우수한 PCHIP (Piecewise Cubic Hermite Interpolating Polynomial) 보간법(Fritsch and Carlson, 1980)을 적용하였다. PCHIP은 2차 미분 연속성은 보장하지 않지만, 형상의 과도한 진동 없이 원래 형상을 안정적으로 보존할 수 있다는 장점을 가진다. 좌표의 일반화를 위해 각 점의 y좌표는 선박의 반폭(B/2), z좌표는 흘수(T)로 각각 무차원화하였다. 최대 높이는 흘수의 1.3배로 설정하여 모든 선박을 동일한 좌표계에서 표현하였다. 축방향 좌표 x는 선수간 거리(LPP)로 무차원화하였다. 본 연구에서는 총 34개의 기본 단면을 사용하였으며, AP (Aft Perpendicular) 후방에는 유체성능에 큰 영향을 미치지 않는 영역을 고려하여 2개의 단면을 추가하였다. 또한 구상선수(Bulbous Bow)의 형상을 보다 정밀하게 표현하기 위하여 FP (Forward Perpendicular) 전방에는 0.1 station 간격으로 5개의 단면을 추가하였다. 각 단면은 총 120개의 점으로 구성하였다.
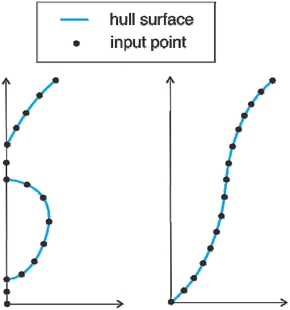
Point generation by PCHIP interpolation
3.2 RGB기반 2차원 CNN
2차원 CNN을 이용하여 선박 형상의 공간적 특징을 학습하기 위해, Ichinose and Taniguchi (2021)과 Byun et al. (2025)이 제안한 RGB기반 형상 표현 방식을 적용하였다. 3.1에서와 같이 얻어진 선형의 점 네트에는 각각(x, y, z)좌표가 대응되는 형태로, 각 점의 성분을 이미지 데이터의 RGB 성분처럼 취급할 수 있고, 선체 표면을 RGB 3채널을 갖는 크기 120 X 34의 이미지로 표현할 수 있다. Fig. 2는 RGB 이미지로 표현된 선형의 예를 보인다.
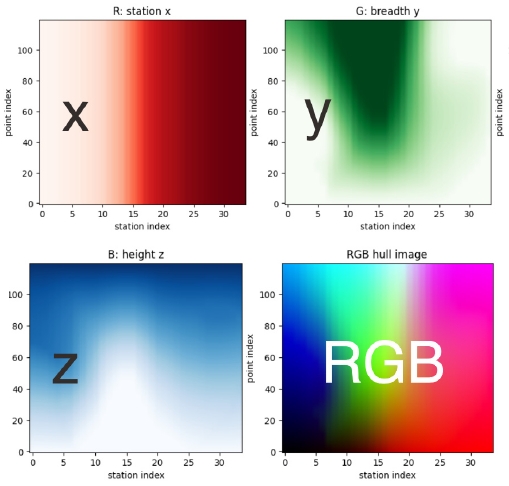
Hullform representation by a RGB image
이미지로 표현된 선형의 국부적인 형상 패턴을 추출하기 위해서 일반적으로 이미지 분석에 널리 사용되는 2차원 CNN을 적용한다. 앞서 언급한 바와 같이 선박의 유체 성능은 선체 형상이 선수에서 선미 방향으로 변하는 것에 영향을 받는다고 생각할 수 있기 때문에 국부적인 패턴에 추가적으로 전역적인 형상 변화를 잡아내는 것이 모델 성능 향상에 도움이 될 것이다. 이를 위해서 합성곱 필터의 크기를 다르게 적용하는 방식을 채택한다. 즉 작은 필터로는 국부적인 형상 변화를 감지하며, 길이방향으로 더 큰 필터를 적용하여 더 넓은 영역의 변화를 감지하는 형태이다. 이렇게 생성된 형상 인코더(geometry encoder)는 두 개의 예측 모델로 전달된다. 하나는 선박의 형상과 주요제원, 그리고 속도(Froude number; Fn)를 입력으로 해당 선박의 전반적인 성능 추세를 예측하는 부분(baseline branch)이고, 다른 하나는 속도와 형상의 상호작용을 반영하는 보정값을 예측하는 부분(residual branch)으로 최종 출력단에서 이 두 개의 값이 더해지는 형태로 구성된다. 속도에 따른 형상 민감도를 위해서 FiLM (Feature-wise Linear Modulation, Perez et al., 2018) 방법을 적용하였다.
FiLM은 속도로부터 생성된 modulation parameter를 이용하여 형상 특징을 채널별로 선형 변조함으로써 속도에 따른 형상 민감도를 효과적으로 학습하는 부분으로 residual branch에서 사용되었다. 오프셋 좌표는 선박의 폭과 흘수를 기준으로 무차원화되므로 상대적인 선박 크기 정보는 포함되지 않는다. 따라서 형상 정보와는 별도로 주요 제원을 추가 입력으로 사용하였다. Fig. 3은 RGB기반 예측 모델의 구성도를 보인다.
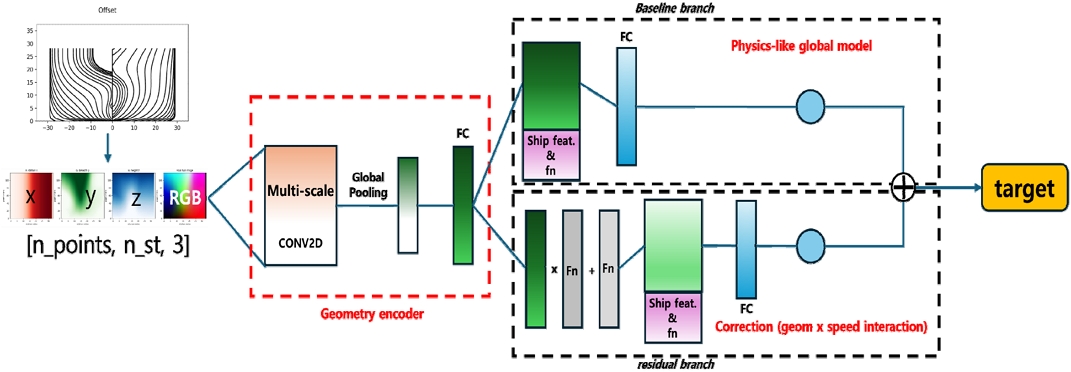
Structure of prediction model based on 2D-CNN method
3.3 1차원 CNN + TCN
선체 길이방향의 형상 변화 패턴을 보다 효과적으로 학습하기 위하여 1차원 CNN과 TCN (Temporal Convolutional Network)을 결합한 모델을 구성하였다. 즉 각 단면의 국부적인 형상 특성은 1차원 CNN을 통해서 추출하고, 이 특성들이 길이방향으로 변하는 패턴을 TCN으로 잡아내는 방식이다. TCN은 순환신경망(RNN)과 달리 모든 시퀀스를 병렬적으로 처리할 수 있으며, gradient 소실이 적고 안정적인 학습이 가능하다. 특히 TCN에서 dilation을 사용하여 바로 이웃하는 단면의 변화 뿐만 아니라 거리가 떨어져 있는 단면들 사이의 패턴도 감지할 수 있는 방법이기 때문에 단면 형상의 변화를 폭 넓게 고려할 수 있다. Fig. 4는 1D CNN과 TCN을 적용한 예측 모델의 구성을 보인다. 모든 단면은 동일한 형식의 단면 데이터이므로 하나의 1D CNN 인코더(time distributed layer)를 모든 단면에 공유하여 적용하였다. 이러한 가중치 공유(weight-sharing) 전략은 단면 형상에 공통적으로 나타나는 기하학적 특징을 효과적으로 학습할 수 있게 하며, 동시에 모델 파라미터 수를 줄여 계산 효율성을 높이고 일반화 성능을 향상시키는 장점을 가진다. 형상 인코더의 뒷부분은 2차원 CNN방법과 동일하게 baseline branch와 residual branch로 구성하여 모델 구조의 일관성을 유지하였다.
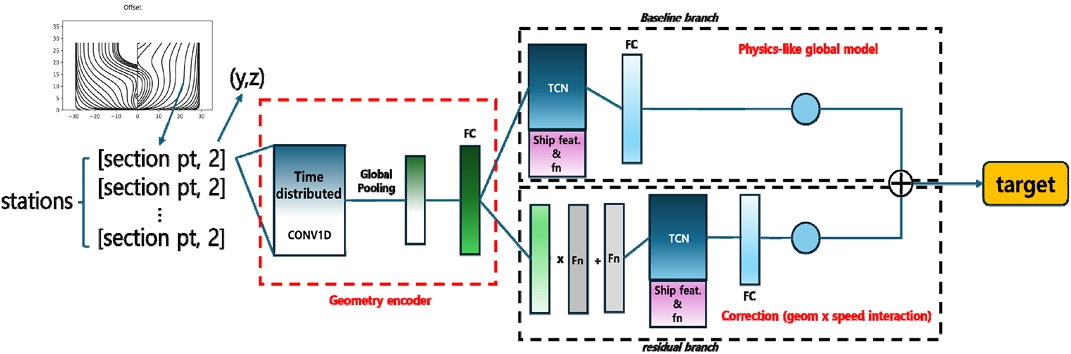
Structure of prediction model based on 1D CNN and TCN method
4. 모델별 잉여저항계수 예측 결과
3장에서 소개한 예측 모델의 성능 비교를 위하여 선박해양플랜트연구소가 보유한 모형시험 결과를 활용하여 학습을 수행하였다. 대상은 저항성능을 대표하는 잉여저항계수(CR)이며 성능 기준을 위하여 선박 오프셋 정보가 빠진 주요 제원만으로의 학습도 수행하였다. 이후 비교의 편의를 위하여 주요 제원만을 입력으로 사용하는 모델을 MLP모델, RGB기반 2차원 CNN을 적용한 모델을 2D-CNN모델, 그리고 1차원 CNN과 TCN을 결합한 모델을 TCN모델로 각각 표기한다.
4.1 학습 데이터 및 학습 방법
학습에 사용된 선형은 총 450척으로 쌍축선(twinskeg ship)은 제외되었으며, 선종은 벌크선, 탱커선 등의 저속비대선과 컨테이너선, 가스운반선이 포함되어 있다. 각 선형의 다양한 속도 조건을 포함하여 총 3,793개의 학습 샘플을 구축하였다. 학습 방법은 다음과 같다. 전체 데이터를 8:2의 비율로 훈련(training) 데이터와 검증(test) 데이터로 분할하였다. 이때 데이터 분할의 기준은 개별 데이터 기준이 아닌 선형 기준(ship-level)을 따르도록 하였다. 분류의 기준을 개별 데이터(Fig. 5)로 할 경우, 학습 모델은 거의 모든 선형을 이미 알고 있는 상태로서 보통 평가 성능이 과대평가될 가능성이 매우 높고 처음 보는 선형의 성능 예측에 불리한 상황이 되기 쉽다. 반면, 선형 기준(Fig. 6)으로 분류를 수행할 경우, 학습 모델은 검증 결과가 다소 떨어질 수 있으나 일반화 성능을 확보하기 유리하여, 성능 추정 모델의 본래 목적과 더 일치하는 방법이라고 볼 수 있다.
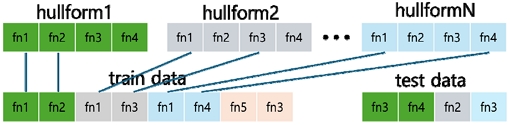
Sample-based train/test split
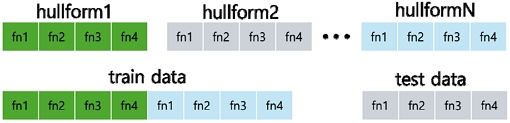
Hullform-based train/test split
모델의 구성에 사용되는 레이어의 유닛 개수, 합성곱 필터 크기, 형상 인코더의 크기 등을 결정하기 위한 하이퍼파라미터 튜닝 과정에서 데이터 분할에 따른 편향을 줄이기 위하여, 훈련-검증 데이터를 다르게 구성하고 학습한 후, 평균적인 성능을 평가하는 k폴드 교차 검증(k-fold cross validation)을 수행하였다. 이렇게 정해진 하이퍼파라미터로 최종 모델 구조를 정하고, 전체 데이터셋에 대한 최종 학습을 진행한다. 이때 서로 다른 초기 가중치(random initialization) 조정을 통해서 5개의 예측 모델을 만들고, 이 모델들의 출력값을 평균하는 앙상블(ensemble) 모델을 최종 모델로 생성하였다. 이를 통해 개별 모델의 분산을 감소시키고, 새로운 선형에 대한 일반화 성능과 예측 안정성을 향상시킬 수 있다.
4.2 MLP 모델
MLP 모델은 입력으로 선박의 주요 제원과 속도 조건만을 사용하여 잉여저항계수를 예측하는 기준 모델이다. 형상 정보(오프셋)를 사용하지 않으므로, 선박 형상 정보가 예측 성능 향상에 미치는 영향을 평가하기 위한 비교 기준으로 활용하였다. 선박의 주요 제원에 해당하는 무차원 변수를 입력변수로 사용하였다. 속도 조건으로 프루드수(Fn)를 사용하였으며, Kim et al. (2019)은 잉여저항 계수가 Fn의 다항식으로 효과적으로 근사될 수 있음을 보인 바 있다. 이에 본 연구에서는 속도에 대한 비선형 의존성을 보다 효과적으로 반영하기 위해 Fn의 다항항을 입력변수로 추가하였다. 다항항의 최대 차수는 모델별 성능을 기준으로 결정하였으며, MLP 모델에서는 3차항까지, 다른 모델에서는 5차항까지 사용하는 것이 가장 우수한 예측 성능을 보였다.
입력 변수는 모두 평균이 0, 표준편차가 1이 되도록 표준화(standardization)를 수행하였으며, 2개의 MLP 레이어(hidden layer)와 출력층으로 구성하였다. 모델의 성능은 결정계수(coefficient of determination, R2)를 이용하여 평가하였으며, R2는 실제 데이터의 분산에 대해 모델이 설명하는 비율을 나타내는 지표이다. 학습 결과, 훈련데이터가 0.856, 검증데이터가 0.842로 나타났으며, 최종 앙상블 모델은 0.884로 조금 향상된 결과를 보였다. 평균 절대오차율(Mean Absolute Percentage Error, MAPE)은 약 11%였으며, 모델별 평균 표준편차는 0.0475이다. Fig. 7은 최종 모델의 예측 결과를 보인다.
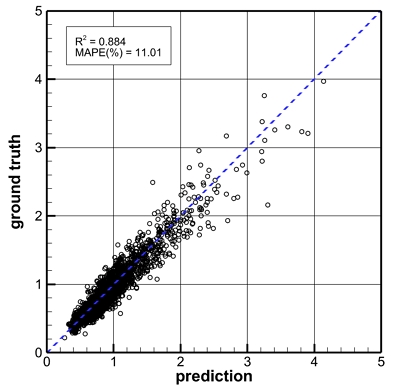
CR prediction by MLP ensemble model
4.3 2D-CNN 모델
2D-CNN모델은 MLP 모델의 입력 변수에 선박 오프셋 형상 정보를 추가하여 학습한 모델이다. 입력 및 출력 정보는 다음과 같다. 오프셋은 34개 단면에서 각각 120개 점의 (x, y, z)좌표가 사용되었다. 속도 변수는 MLP 모델에서는 Fn의 3차 다항식 항까지 사용하였으나, 2D-CNN 모델에서는 5차 성분까지 고려하는 것이 예측 성능 향상에 효과적이었으므로 이를 최종 입력으로 사용하였다.
서로 다른 크기의 CNN 필터를 적용한 3개의 CNN 블록을 형상 인코더로 사용하였으며, 이후 baseline branch와 residual branch에는 각각 2개의 MLP 레이어를 배치하였다. 훈련데이터의 결정계수가 0.974, 검증데이터가 0.915로 나타났으며, 최종 앙상블 모델은 0.961의 결과를 보였다. 평균 절대오차율은 약 7.6%였으며, 모델별 평균 표준편차는 0.0587로 MLP모델 대비 다소 크게 나타났다. Fig. 8은 2D-CNN모델의 잉여저항계수 예측 결과를 보인다. 주요 제원이 유사한 선박의 경우 저항계수의 차이는 선박의 형상에 기인한다고 가정할 수 있으며, 현재의 CNN 모델은 그 차이를 반영하기 위해서 도입된 방법이다. 이러한 선박 형상 민감도를 평가하기 위하여 Group-centered RMSE (Root Mean Square Error)와 Pairwise Accuracy를 사용하였다. Group-centered RMSE는 주요 제원이 유사한 각 그룹에서 실측값과 예측값의 그룹 평균을 각각 제거한 후 계산한 RMSE로, 그룹 내 형상 변화에 따른 잉여저항계수의 상대적 차이에 대한 예측 정확도를 나타낸다. Pairwise Accuracy (Deutsch et al., 2023)는 동일 그룹에 속한 모든 선박쌍을 대상으로 실측 잉여저항계수의 대소관계와 모델이 예측한 대소관계가 일치하는 비율로 정의하였다.
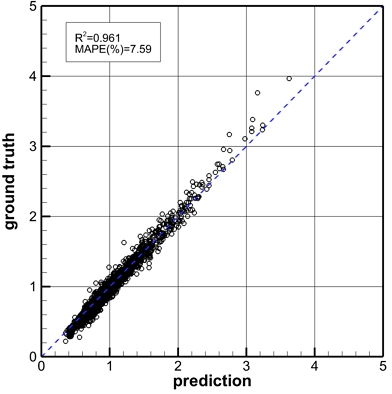
CR prediction by 2D-CNN ensemble model
2D-CNN 모델의 경우, 주요제원이 각각 3% 이내의 차이를 갖는 선박들을 유사선박이라고 가정하였을 경우, group-centered RMSE가 0.0296, pairwise accuracy가 약 76%로 나타났다. 즉 유사 주요제원을 갖는 선박의 잉여저항계수 값을 평균적으로 약 0.029 오차로 예측을 하고 있으며, 형상에 따른 저항계수 증감을 약 76%정도 정확도로 예측하고 있다고 평가할 수 있다. 본 평가는 주요 제원이 완전히 동일한 선박을 대상으로 수행한 것은 아니지만, 형상 변화에 대한 모델의 민감도를 정량적으로 평가할 수 있는 간접적인 지표로 활용될 수 있다.
4.4 TCN 모델
TCN 모델은 3.3절에서 설명한 바와 같이 각 단면의 형상 특징을 1차원 time-distributed CNN을 이용하여 추출하고, 단면별 특징 벡터의 길이방향 변화 패턴을 TCN을 통해 학습하도록 구성하였다. 입출력 정보는 2D-CNN과 동일하다. 형상 인코더는 3개의 1차원 CNN 레이어와 dilation convolution을 적용한 3개의 TCN 블록으로 구성하였다. 2D-CNN 모델과 동일하게 baseline branch와 residual branch의 MLP 레이어수는 2개로 설정하였다. 훈련데이터의 결정계수가 0.957, 검증데이터가 0.920으로 2D-CNN 모델 대비 훈련데이터는 낮게, 검증데이터는 높게 나타났으며, 최종 앙상블 모델은 0.959의 결과를 보였다. 이는 TCN이 길이방향 형상 변화를 보다 효과적으로 일반화하여 과적합을 일부 완화한 결과로 판단된다. 평균 절대오차율은 약 7.2%였으며, 모델별 평균 표준편차는 0.0631이다. Group-centered RMSE가 0.0299, pairwise accuracy가 약 76%로 2D-CNN과 동일한 수준의 형상 민감도를 보였다. Fig. 9는 TCN 모델의 잉여저항계수 예측 결과를 보인다.
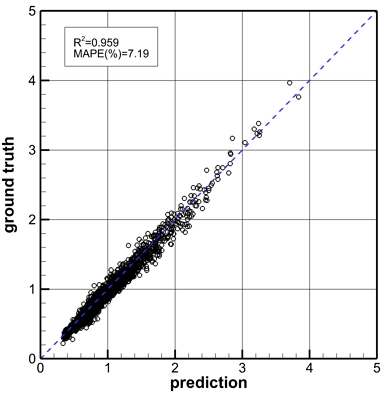
CR prediction by TCN ensemble model
5. 모델별 추진 성능 예측 결과
선박의 동력 성능 추정을 위해서는 저항 성능뿐만 아니라 추진 성능과 관련된 유효반류계수(wS)와 추력감소계수(t)를 예측할 필요가 있다. 본 장에서는 4장에서 제시한 잉여저항계수 예측 모델과 동일한 구조를 사용하되, 출력 부분을 유효반류계수와 추력감소계수로 변경한 모델의 학습 결과를 제시한다. 학습에 사용된 선형은 총 443척이며, 속도 조건을 고려한 총 샘플 수는 3,101개이다. 훈련 데이터와 검증 데이터의 분류, 하이퍼파라미터 튜닝 및 앙상블 모델 생성 방법 등은 잉여저항계수 예측 모델 생성의 경우와 동일하다. 다만 추진 성능 예측 모델에서 유효반류계수와 추력감소계수는 선각효율(ηH)와 관계를 갖고 있기 때문에 손실함수(loss function)를 정의할 때, 각 출력 변수의 평균제곱오차(Mean Squared Error; MSE)뿐만 아니라 예측한 값으로 계산되는 선각효율과 모형시험의 선각효율의 차이를 최소화하는 항을 추가하여 구성하였다. 이를 통해 각 계수의 개별 예측 정확도뿐만 아니라 추진 성능을 결정하는 물리적 관계도 함께 만족하도록 하였다.
5.1 MLP 모델
MLP 모델의 입출력 정보는 다음과 같다. 추력감소계수의 경우는 선체 뿐만 아니라 프로펠러의 영향도 고려할 필요가 있기 때문에 프로펠러 직경(DP)과 평균피치비(P/Dmean)를 입력 변수에 추가하였다. 초기 선형 설계시 프로펠러 상세 제원이 결정되지 않은 상황에서도 사용할 수 있도록 프로펠러 관련 입력 변수는 직경과 평균피치비 만을 고려하였다.
MLP 레이어의 수는 잉여저항계수 예측 모델과 동일하며, 레이어별 유닛수는 하이퍼파라미터 튜닝을 통하여 결정하였다. 학습 결과 훈련 데이터 및 검증 데이터의 결정계수는 유효반류계수의 경우 0.779와 0.748, 추력감소계수의 경우 각각 0.581, 0.425로 나타났다. 이는 잉여저항계수 예측 모델에 비해 두 추진계수의 예측이 상대적으로 어려움을 보여준다. 최종 앙상블 모델은 결정계수 0.803, 0.574, 평균절대오차율은 각각 약 5.1%, 6.3%를 보였다. 모델별 표준편차는 각각 0.00376, 0.00267이다. 잉여저항계수 예측 모델보다 결정계수는 낮게 나타났으나 평균절대오차율은 오히려 작게 나타났다. 이는 유효반류계수와 추력감소계수가 잉여저항계수에 비해 값의 변동 범위가 상대적으로 작아, 개별 샘플 간의 변별력은 다소 낮지만 절대적인 예측 오차는 작게 나타난 결과로 판단된다.
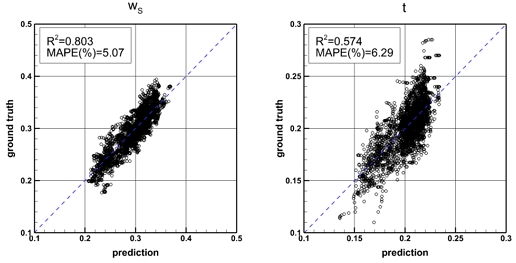
wS and t prediction by MLP model
5.2 2D-CNN 모델
모델의 입출력 변수는 다음과 같다.
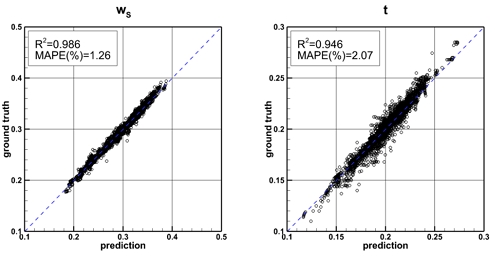
wS and t prediction by 2D-CNN model
유효반류계수의 경우, 훈련 데이터와 검증 데이터에 대한 결정계수값은 0.955, 0.876이었으며, 추력감소계수의 경우, 각각 0.876, 0.566으로 MLP 모델 대비 향상된 결과를 보여주었다. 잉여저항계수보다 선박 형상 정보의 기여도가 상대적으로 크게 나타났다. 최종 앙상블 모델의 결정계수는 각각 0.986, 0.946이며, 평균절대오차율은 약 1.3, 2.1%였다. 모델별 표준편차는 0.00704, 0.00492로 나타났다. 형상 민감도를 보기 위한 group-centered RMSE는 각각 0.0055, 0.0075이며, pairwise accuracy는 약 71%, 74% 수준이다.
5.3 TCN 모델
모델의 입출력 변수는 2D-CNN 모델과 동일하다. 유효반류계수와 추력감소계수에 대하여, 결정계수는 훈련 데이터가 0.939, 0.862, 검증 데이터가 0.811, 0.499로 2D-CNN 모델 대비 근소하게 낮은 값을 보여주고 있다. 최종 앙상블 모델은 각각에 대한 결정계수가 0.982, 0.941, 평균절대오차율이 약 1.4, 2.2%로 2D-CNN 모델과 유사한 수준을 보여준다. 평균 표준편차는 0.00621, 0.00560이었다. 형상 민감도 평가 결과, group-centered RMSE는 유효반류계수와 추력감소계수에서 각각 0.0050과 0.0074를 나타냈으며, pairwise accuracy는 각각 약 82%와 76%로 확인되었다. 이는 TCN 모델이 선박 형상에 따른 추진 성능의 상대적인 변화를 효과적으로 학습하고 있음을 보여주는 결과이다.
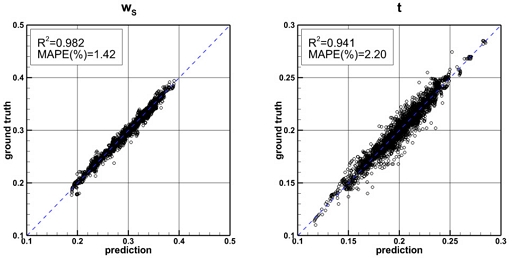
wS and t prediction by TCN model
6. 결 론
본 연구에서는 선박의 초기 설계 단계에서 선형 최적화에 활용 가능한 대리자 모델(surrogate model)을 구축하기 위해, 선박 형상 정보를 기계학습 모델에 적용하는 두 가지 방법을 제안하고 그 성능을 비교하였다. 첫 번째 방법은 오프셋 정보를 RGB 이미지로 변환하여 2차원 CNN에 입력하는 방법이며, 두 번째 방법은 오프셋 정보를 직접 입력으로 사용하고 1차원 CNN과 TCN을 결합하여 길이방향 형상 변화 패턴을 학습하는 방법이다. 또한 비교 기준으로 선박 형상 정보를 사용하지 않고 주요 제원만을 입력으로 하는 MLP 모델도 함께 구축하였다. 각 모델은 잉여저항계수, 유효반류계수 및 추력감소계수를 예측하도록 학습하였으며, 그 결과를 Table 1~3에 정리하였다.

Summary of CR prediction (ensemble model)
Summary of wS prediction (ensemble model)
Summary of t prediction (ensemble model)
모든 성능 지표에서 선박 형상 정보를 입력으로 사용하는 모델은 주요 제원만을 사용하는 MLP 모델보다 우수한 예측 성능을 나타냈다. 이는 선박 형상 정보를 직접 활용하는 것이 유체성능 예측 정확도 향상에 효과적임을 보여준다. 반면, 오프셋 정보를 RGB 이미지로 표현하는 방법(2D-CNN)과 종방향 단면 시퀀스로 표현하는 방법(TCN) 사이의 평균적인 예측 성능 차이는 크지 않은 것으로 나타났다. 이는 오프셋 정보를 이용하는 경우, 국부적인 형상 특징과 길이방향 형상 변화를 효과적으로 학습할 수 있는 구조를 적용하면 입력 표현 방식 자체는 모델 성능에 결정적인 영향을 미치지 않음을 의미한다.
추진 성능 예측에서는 두 모델 모두 높은 예측 성능을 보였으며, 평균적인 정확도는 유사한 수준으로 나타났다. 그러나 형상 민감도 평가에서는 TCN 모델이 다소 우수한 결과를 보여, 길이방향 형상 변화 패턴을 직접 학습하는 구조가 형상에 따른 상대적인 성능 차이를 표현하는 데 유리할 가능성을 확인하였다. 또한 본 연구에서 적용한 앙상블 기법은 개별 모델의 예측 분산을 감소시키고 초기 가중치 및 데이터 분할에 대한 민감도를 완화하여 보다 안정적이고 신뢰성 있는 예측 결과를 제공하는 것으로 확인되었다.
본 연구는 선박 형상 정보를 기계학습 모델에 효과적으로 활용하기 위한 두 가지 형상 표현 및 학습 구조를 동일한 데이터셋에서 비교·평가하였으며, 평균적인 예측 성능뿐 아니라 형상 민감도까지 함께 평가함으로써 각 모델의 특성을 정량적으로 분석하였다는데 의의가 있다.
향후에는 보다 다양한 선종과 대규모 CFD 데이터베이스를 구축하여 학습 데이터를 확장하고, 이를 통해 형상 다양성에 대한 일반화 성능을 향상시킬 필요가 있다. 또한 본 연구에서 제안한 모델을 선형 최적화 과정의 대리자 모델로 활용하여 CFD 계산 횟수를 줄이고 설계 시간을 단축하는 연구를 수행할 계획이다.
Acknowledgments
본 논문은 선박해양플랜트연구소 전략연구사업 “AI기반 선박형상설계 지원시스템 개발(PET0050)”으로 수행된 결과입니다.
References
- Byun, B.J., Lee, S.H., Kim, Y.C., Yeon, S.M., Kim, K.S., and Yang, K.K., 2025. Prediction of ship resistance and wave profiles using machine learning with hull sectional geometry data. 16th International Symposium on Practical Design of Ships and Other Floating Structures, Ann Arbor, USA, 19-23 October 2025.
-
Cho, Y.I., Oh, M.J., Seok, Y.S., Lee, S.J. and Rho, M.I., 2019. Resistance estimation of a ship in the initial hull design using deep learning. Korean Journal of Computational Design and Engineering, 24(2), pp.203-210.
[https://doi.org/10.7315/CDE.2019.203]

-
Deutsch, D., Foster, F. and Freitag, M., 2023. Ties matter: meta-evaluating modern metrics with pairwise accuracy and tie calibration. arXiv:2305.14324.
[https://doi.org/10.18653/v1/2023.emnlp-main.798]
-
Fritsch, F.N. and Carlson, R.E., 1980, Monotone piecewise cubic interpolation. SIAM Journal on Numerical Analysis, 17, pp.238-246.
[https://doi.org/10.1137/0717021]
- Holtrop, J., 1984. A statistical re-analysis of resistance and propulsion data. International Shipbuilding Progress, 31, pp.272-276.
-
Holtrop, J. and Mennen, G.G.J., 1978. A statistical power prediction method. International Shipbuilding Progress, 25, pp.253.
[https://doi.org/10.3233/ISP-1978-2529001]
-
Holtrop, J. and Mennen, G.G.J., 1982. An approximate power prediction method. International Shipbuilding Progress, 29, pp.166-170.
[https://doi.org/10.3233/ISP-1982-2933501]
-
Ichinose, Y. and Taniguchi, T., 2021. A curved surface representation method for convolutional neural network of wake field prediction. Journal of Marine Science and Technology, 27, pp.637-647.
[https://doi.org/10.1007/s00773-021-00857-3]
-
Kim, Y.C., Kim, G.D., Yeon, S., Hwang, S.H., Lee, Y.Y., and Kim, K.S., 2024. Estimation for nominal wake field of ships by using machine learning model. Journal of the Society of Naval Architects of Korea, 61(5), pp.354-363.
[https://doi.org/10.3744/SNAK.2024.61.5.343]
-
Kim, Y.C., Kim, K.S., Hwang, S.H. and Yeon, S., 2022. Prediction of residual resistance coefficient of ships using convolutional neural network. Journal of the Society of Naval Architects of Korea, 59(4), pp.243-250.
[https://doi.org/10.3744/SNAK.2022.59.4.243]
-
Kim, Y.C., Kim, K.S., Yeon, S., Lee, Y.Y., Kim, G.D. and Kim, M.S., 2023. Power prediction method for ships using data regression models. Journal of Marine Science and Engineering, 11, 1961.
[https://doi.org/10.3390/jmse11101961]
-
Kim, Y.C., Kim, M.S., Yang, K.K., Lee, Y.Y., Yim, G.T., Kim, J., Hwang, S.S., Kim, J. and Kim, K.S., 2019. Prediction of residual resistance coefficient of low-speed full ships using hull form variables and model test results. Journal of the Society of Naval Architects of Korea, 56(5), pp.448-457.
[https://doi.org/10.3744/SNAK.2019.56.5.447]
-
Park, J., Choi, M. and Song, G., 2023. Prediction of ship resistance performance based on the convolutional neural network with voxelization. Journal of the Society of Naval Architects of Korea, 60(2), pp.110-119.
[https://doi.org/10.3744/SNAK.2023.60.2.110]
-
Perez, E., Strub, F., de Vries, H., Dumoulin, V. and Courville, A., 2018, FiLm: Visual reasoning with a general conditioning layer, arXiv:1709.07871v2, .
[https://doi.org/10.1609/aaai.v32i1.11671]
-
Seo, J., Kim, D. and Lee, I., 2024. A study on ship hull form transformation using convolutional autoencoder. Journal of Computational Design and Engineering, 11(1), pp.34-48.
[https://doi.org/10.1093/jcde/qwad111]
Yoo-Chul Kim: Conceptualization, Data curation, Formal analysis, Methodology, Validation, Visualization, Writing – original draft; Byung-Jin Byun: Methodology; Seongmo Yeon: Data curation, Writing – review & editing; Seok-Hwan Oh: Data curation; Kwang-Soo Kim: Supervision, Writing – review & editing; Kyung-Kyu Yang: Methodology, Writing – review & editing; Seung-Hyun Hwang: Data curation, Project administration.